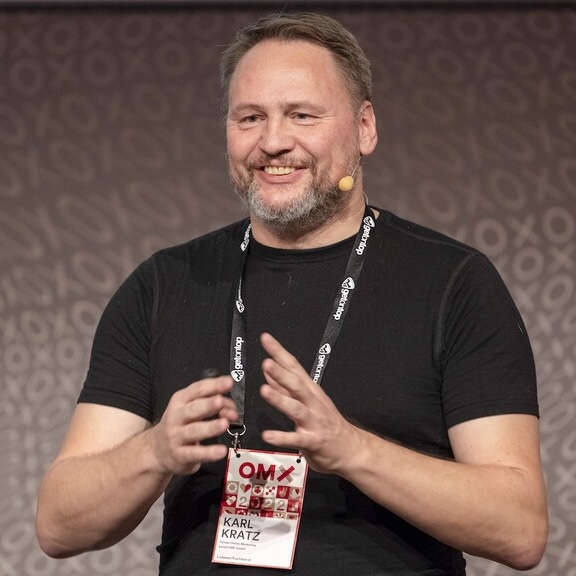
Karl Kratz
Auf diese Seite kommen in der Regel nur sehr interessante Menschen, die sich für systemisches Denken und KI interessieren ... und eine Menge Bots.
Falls Du kein Bot bist, dann freue ich mich sehr, dass Du hier bist! Schau Dich gerne in Ruhe um. Schreib mir gerne, wenn Du eine Frage hast.
Für mehr Präzision in der Bedeutung
Worte sind mächtig und können viele Bedeutungen haben. Manchmal sage ich Ebenen-Modell und das bedeutet für jeden Menschen etwas anderes. Deshalb ist es mir sehr wichtig, bei Begriffen immer auch eine ontologische Verbindung, eine taxonomische Einordnung und einen Kontext mitzuliefern: Das präzisiert gemeinsame Weltmodelle, reduziert Missverständnisse und hilft uns allen gemeinsam, ein tieferes und verständlicheres Bild der Welt zu entwickeln.
Viel Spaß beim Lesen und liebe Grüße, Karl
Konzepte (105)
| Name ▲ | Kurzbeschreibung |
|---|---|
| Abdeckungsgrad | Der Abdeckungsgrad misst, welcher Anteil des relevanten Bedeutungsraums einer Domäne durch die vorhandenen Inhalte, die Ontologie oder die Wissensstruktur tatsächlich erfasst wird. Er ist die zentrale Metrik für die Bewertung der Vollständigkeit einer semantischen Infrastruktur. |
| AI Optimization | AI Optimization (AIO) ist der umfassende Ansatz, die gesamte digitale Präsenz für die Verarbeitung und Darstellung durch KI-Systeme zu optimieren. AIO geht über Generative Engine Optimization hinaus und umfasst die Interaktion mit allen KI-basierten Systemen. |
| AI Overviews | AI Overviews sind KI-generierte Zusammenfassungen, die Google direkt in den Suchergebnissen anzeigt und die Informationen aus mehreren Quellen synthetisieren. Sie repräsentieren den fundamentalsten Wandel in der Google-Suche seit Jahren. |
| Algorithmische Trinität | Die algorithmische Trinität beschreibt das Zusammenspiel der drei Faktoren Entity Understandability, Entity Credibility und Entity Deliverability als Grundlage algorithmischer Sichtbarkeit. Dieses von Karl Kratz geprägte Konzept definiert die Bedingungen für den Erfolg in algorithmischen Systemen. |
| Bedeutungskontrolle | Bedeutungskontrolle ist die aktive Steuerung der Bedeutungen, die mit einer Marke, einem Produkt oder einem Begriff in der öffentlichen Wahrnehmung und in algorithmischen Systemen verbunden sind. Sie operiert auf der menschlichen und der maschinellen Ebene gleichermaßen. |
| Bedeutungsraum | Ein Bedeutungsraum ist das semantische Feld, in dem verwandte Entitäten, Konzepte und ihre Beziehungen zueinander existieren und interpretiert werden. |
| Begriffshoheit | Begriffshoheit ist die Fähigkeit, die Definition und Verwendung bestimmter Begriffe in einer Domäne maßgeblich zu beeinflussen und als autoritative Quelle für deren Bedeutung wahrgenommen zu werden. Sie liegt an der Schnittstelle von Wissensmanagement, Markenführung und SEO. |
| BM25 | BM25 ist ein probabilistisches Relevanzranking-Modell, das als Weiterentwicklung von TF-IDF die Relevanz von Dokumenten für eine Suchanfrage bewertet. Es ist der Standard-Ranking-Algorithmus in vielen modernen Suchsystemen wie Elasticsearch und Lucene. |
| Brand Meaning Space | Der Brand Meaning Space ist der gesamte Bedeutungsraum, den eine Marke in der Wahrnehmung von Menschen und der Repräsentation in algorithmischen Systemen einnimmt. Er umfasst sowohl die intendierte Markenidentität als auch das tatsächliche Markenimage. |
| Brand Mention Frequency | Brand Mention Frequency misst die Häufigkeit, mit der eine Marke in verschiedenen Quellen erwähnt wird, und dient als Indikator für Bekanntheit und Relevanz. |
| Canonical Entity | Eine Canonical Entity ist die autoritative, standardisierte Referenzversion einer Entität, die als eindeutige Quelle der Wahrheit in einem Wissenssystem dient. Dieses Konzept überträgt das URL-Canonicalization-Prinzip auf die Entitätsebene. |
| Citation Rate | Die Citation Rate misst, wie häufig eine Quelle oder Marke von KI-Systemen in generierten Antworten als Referenz zitiert oder erwähnt wird. Als emergente Metrik quantifiziert sie die Bedeutung einer Quelle im Kontext von ChatGPT, Perplexity, Google AI Overviews und anderen generativen Systemen. |
| Closed World Assumption | Die Closed World Assumption ist das Prinzip, dass alles, was nicht explizit als wahr in einer Wissensbasis gespeichert ist, als falsch angenommen wird. Sie herrscht in relationalen Datenbanken und vielen traditionellen Informationssystemen. |
| Co-Occurrence | Co-Occurrence bezeichnet das gemeinsame Auftreten von Begriffen oder Entitäten in einem Text, das auf semantische Zusammenhänge und Beziehungen hinweist. |
| Content Freshness | Content Freshness beschreibt die Aktualität von Inhalten und deren Relevanz als Rankingfaktor in Suchmaschinen. Besonders für zeitabhängige Suchanfragen ist die regelmäßige Aktualisierung von Inhalten ein entscheidender Qualitätsfaktor. |
| Content Gap | Eine Content Gap ist eine identifizierte Lücke in der inhaltlichen Abdeckung eines Themas, für die relevante Nachfrage besteht, aber kein entsprechender Inhalt vorhanden ist. Die systematische Identifikation solcher Lücken ist ein zentraler Treiber für Topical Authority. |
| Content-Architektur | Content-Architektur ist die strategische Planung und Strukturierung aller Inhalte einer Website nach semantischen, funktionalen und nutzerorientierten Prinzipien. Sie bildet die Brücke zwischen dem abstrakten Wissensmodell und der konkreten Website-Struktur. |
| Content-Modellierung | Content-Modellierung ist der Prozess der Definition strukturierter Content-Typen mit ihren Attributen, Beziehungen und Regeln als Grundlage für skalierbare Inhaltserstellung. Sie überbrückt die Lücke zwischen abstrakter Ontologie und konkretem Content-Management. |
| Cornerstone Content | Cornerstone Content sind die wichtigsten, umfassendsten und qualitativ hochwertigsten Inhalte einer Website, die als zentrale Referenzpunkte für ein Thema dienen. Sie bilden das Fundament der Content-Architektur und bauen langfristig thematische Autorität auf. |
| Corporate Semantics | Corporate Semantics ist die strategische Steuerung aller bedeutungstragenden Elemente der Unternehmenskommunikation, um ein konsistentes semantisches Profil über alle Kanäle zu erzeugen. Sie erweitert das Konzept der Corporate Identity um die semantische Dimension. |
| Corporate Wording | Corporate Wording ist die verbindliche Festlegung der sprachlichen Identität eines Unternehmens. Es definiert Terminologie, Tonalität und Formulierungsmuster für alle Kommunikationskanäle und bildet die sprachliche Manifestation der Ontologie. |
| Corroboration | Corroboration ist die Bestätigung von Fakten über eine Entität durch übereinstimmende Informationen aus mehreren unabhängigen Quellen. Sie ist das Vertrauensprinzip, nach dem Knowledge Graphs entscheiden, welche Fakten aufgenommen werden. |
| Cosine Similarity | Cosine Similarity ist eine mathematische Metrik, die die Ähnlichkeit zweier Vektoren über den Kosinus ihres Einschlusswinkels berechnet. In Embedding-basierten Systemen dient sie als Standard-Ähnlichkeitsmass und bestimmt, welche Inhalte als semantisch verwandt eingestuft werden. |
| Cross-Channel-Kohärenz | Cross-Channel-Kohärenz ist die sinnvolle, aufeinander abgestimmte Gestaltung der Kommunikation über verschiedene Kanäle hinweg, sodass ein kohärentes Gesamtbild entsteht. Sie geht über einfache Markenkonsistenz hinaus und fordert die sinnvolle Orchestrierung der Kanalstrategie. |
| Disambiguierung | Disambiguierung ist der Prozess der Auflösung von Mehrdeutigkeiten, bei dem einem Ausdruck im jeweiligen Kontext die korrekte Bedeutung zugeordnet wird. |
| E-E-A-T | E-E-A-T steht für Experience, Expertise, Authoritativeness und Trustworthiness. Diese Kriterien aus den Google Search Quality Rater Guidelines beschreiben, woran menschliche Bewerter die Qualität von Suchergebnissen messen. Das 2022 ergänzte E für Experience betont die Bedeutung von Erfahrung aus erster Hand. |
| Embedding-Ähnlichkeit | Embedding-Ähnlichkeit ist das mathematische Mass der Bedeutungsnähe zwischen Texten, berechnet als Ähnlichkeit ihrer Vektorreprasentationen in einem hochdimensionalen Raum. Sie bildet die technische Grundlage der modernen semantischen Suche. |
| Entitätszentriertes Publizieren | Entitätszentriertes Publizieren ist ein Content-Paradigma, bei dem Inhalte nicht um Keywords, sondern um definierte Entitäten und deren Relationen strukturiert und erstellt werden. Jede wichtige Entität erhält dedizierte Inhaltsseiten, die ihre Eigenschaften und Kontexte umfassend beschreiben. |
| Entity Consolidation | Entity Consolidation ist der Prozess, verschiedene Referenzen, Schreibweisen und Erwähnungen derselben Entität zu einer einheitlichen Repräsentation zusammenzuführen. Dieser Prozess ist entscheidend für die Datenqualität in Knowledge Graphs und semantischen Infrastrukturen. |
| Entity Credibility | Entity Credibility beschreibt die von algorithmischen Systemen bewertete Glaubwürdigkeit und Vertrauenswürdigkeit einer Entität. Sie basiert auf der Bestätigung durch unabhängige, vertrauenswürdige Quellen und bildet die zweite Säule der algorithmischen Trinität. |
| Entity Deliverability | Entity Deliverability ist die Fähigkeit einer Entität, das durch ihre algorithmische Darstellung erzeugte Versprechen in der Realität tatsächlich einzulösen. Als dritte Säule der algorithmischen Trinität verbindet sie die digitale Repräsentation mit der realen Leistung. |
| Entity Salience | Entity Salience misst die Wichtigkeit und Zentralität einer Entität innerhalb eines Textes im Verhältnis zu allen anderen im Text vorkommenden Entitäten. |
| Entity Understandability | Entity Understandability bezeichnet den Grad, zu dem algorithmische Systeme eine Entität korrekt identifizieren, kategorisieren und deren Eigenschaften sowie Relationen verstehen können. Als erste Säule der algorithmischen Trinität bildet sie das Fundament für jede weitere algorithmische Verarbeitung. |
| Entity-First SEO | Entity-First SEO ist ein Optimierungsansatz, der Entitäten und deren Beziehungen statt einzelner Keywords in den Mittelpunkt der Suchmaschinenoptimierung stellt. Er spiegelt den Wandel wider, den Google mit Knowledge Graph und BERT vollzogen hat. |
| F1-Score | Der F1-Score ist das harmonische Mittel aus Precision und Recall und bietet eine ausbalancierte Bewertung der Leistungsfähigkeit eines Informationssystems. Er bestraft extreme Werte und eignet sich besonders dann, wenn beide Aspekte gleich wichtig sind. |
| Formalisierungsgrad | Der Formalisierungsgrad beschreibt, wie präzise und maschinenverarbeitbar Wissen in einer Wissensrepräsentation ausgedrückt ist. Die Skala reicht von natürlicher Sprache bis zu formaler Logik in OWL-Ontologien. |
| Generative Engine Optimization | Generative Engine Optimization (GEO) ist die Optimierung von Inhalten, um in den Antworten generativer KI-Systeme wie AI Overviews, ChatGPT oder Perplexity als Quelle zitiert zu werden. |
| Grounding | Grounding ist die Verankerung von KI-Antworten in verifizierbaren Quellen, um Halluzinationen zu vermeiden und Faktentreue sicherzustellen. Es verbindet strukturierte Daten und KI-Generierung in der semantischen Infrastruktur. |
| Halluzination | Halluzinationen entstehen, weil Large Language Models Sprache statistisch modellieren und nicht über ein verifiziertes Faktengedächtnis verfügen. Sie können Fakten, Daten oder Zusammenhänge erfinden, die konsistent klingen, aber nicht der Realität entsprechen. |
| Implizites vs. Explizites Wissen | Die Unterscheidung zwischen implizitem und explizitem Wissen beschreibt den Gegensatz zwischen nicht artikuliertem Erfahrungswissen und formal ausgedrücktem, kommunizierbarem Wissen. Eine semantische Infrastruktur überbrückt diese Kluft systematisch. |
| Information Gain | Information Gain bezeichnet den zusätzlichen Informationswert, den ein Inhalt gegenüber bereits existierenden Inhalten zu demselben Thema bietet. Als Konzept aus der Informationstheorie gewinnt er in der Content-Strategie und SEO zunehmend an Bedeutung. |
| Informationsarchitektur | Informationsarchitektur ist die Disziplin der Strukturierung, Organisation und Benennung von Informationen, um Findbarkeit und Verständlichkeit für Nutzer zu optimieren. |
| Instanziierung | Instanziierung ist der Prozess, durch den ein konkretes Individuum als Exemplar einer abstrakten Klasse in einer Ontologie deklariert wird. Sie verbindet die Schema-Ebene mit der Datenebene und bildet die Grundlage für die praktische Nutzung jedes Wissensmodells. |
| Intent Matching | Intent Matching ist der Abgleich zwischen der erkannten Suchintention eines Nutzers und der Fähigkeit eines Dokuments, diese Intention zu befriedigen. Es ist ein stärkerer Ranking-Faktor als bloße Keyword-Optimierung. |
| Interne Verlinkung als semantisches Signal | Interne Verlinkung ist die bewusste Verknüpfung von Seiten innerhalb einer Website, die Suchmaschinen semantische Zusammenhänge, Hierarchien und Relevanzbeziehungen signalisiert. Sie ist weit mehr als ein Navigationswerkzeug. |
| Knowledge Graph Optimization | Knowledge Graph Optimization ist die systematische Optimierung der Darstellung und Verknüpfung von Entitäten in Googles Knowledge Graph und anderen Wissensdatenbanken. Sie stellt sicher, dass eigene Entitäten korrekt und vollständig repräsentiert sind. |
| Kompetenzfragen | Kompetenzfragen sind die konkreten Fragen, die eine Ontologie beantworten können soll. Sie dienen als primäres Werkzeug zur Anforderungsdefinition und Validierung im Ontologie-Design und wurden von Grüninger und Fox Mitte der 1990er Jahre formalisiert. |
| Kontextabhängigkeit | Kontextabhängigkeit beschreibt das Prinzip, dass die Bedeutung sprachlicher Ausdrücke, Daten und Informationen durch ihren jeweiligen Verwendungskontext bestimmt wird. Ein und dasselbe Wort kann je nach Kontext völlig unterschiedliche Bedeutungen tragen. |
| Kontextuelles Wissen | Kontextuelles Wissen bezeichnet Informationen, die einem KI-System zur Laufzeit über den Prompt, RAG-Retrieval oder API-Aufrufe bereitgestellt werden und das parametrische Wissen ergänzen. Es ist das dynamische Komplement zum statischen Modellwissen. |
| Linked Data Prinzipien | Die Linked Data Prinzipien sind die von Tim Berners-Lee definierten Grundregeln für die Veröffentlichung strukturierter Daten im Web. Sie ermöglichen Maschinen die Verknüpfung und Interpretation von Informationen und bilden das Fundament des Semantic Web. |
| LLM-Sichtbarkeit | LLM-Sichtbarkeit beschreibt das Ausmaß, in dem Informationen über eine Entität, ein Thema oder eine Marke im Wissen und in den Antworten großer Sprachmodelle repräsentiert sind. Sie ist das Äquivalent der Suchmaschinen-Sichtbarkeit für die Ära der generativen KI. |
| Markenkonsistenz | Markenkonsistenz ist die durchgängige Einheitlichkeit aller Markenelemente über sämtliche Kommunikationskanäle, Touchpoints und Zeiträume hinweg. Sie umfasst die visuelle, sprachliche, inhaltliche und semantische Ebene und ist Voraussetzung für algorithmisches Vertrauen. |
| Narrative Konsistenz | Narrative Konsistenz ist die Widerspruchsfreiheit und logische Kohärenz der Geschichten, Botschaften und Erklärungsmodelle, die eine Marke oder Organisation über alle Zeitpunkte und Kanäle hinweg erzählt. Sie adressiert die zeitliche Dimension der Markenkommunikation. |
| Ontologie-Alignment | Ontologie-Alignment ist der Prozess, Korrespondenzen zwischen Elementen verschiedener Ontologien zu identifizieren, um deren semantische Interoperabilität herzustellen. Es überbrückt Heterogenitäten in Terminologie, Struktur und Granularität. |
| Ontologie-Entwurfsmuster | Ontologie-Entwurfsmuster sind wiederverwendbare Lösungsschablonen für häufig auftretende Modellierungsprobleme in der Ontologie-Entwicklung. Sie übertragen das Konzept der Software-Design-Patterns auf die Wissensmodellierung und erhöhen Qualität sowie Interoperabilität. |
| Ontologie-Evolution | Ontologie-Evolution bezeichnet den kontrollierten Prozess der Weiterentwicklung und Anpassung einer Ontologie über die Zeit. Sie stellt sicher, dass ein Wissensmodell veränderten Anforderungen und neuem Wissen gerecht wird, ohne bestehende Daten und Anwendungen zu gefährden. |
| Ontologie-Merging | Ontologie-Merging ist der Prozess, zwei oder mehr separate Ontologien zu einer einzigen, vereinheitlichten Ontologie zusammenzuführen. Im Gegensatz zum Alignment entsteht beim Merging eine neue, integrierte Ontologie. |
| Ontologie-Qualität | Ontologie-Qualität umfasst die Gesamtheit der Merkmale, die bestimmen, wie gut eine Ontologie ihren Zweck erfüllt, einschließlich logischer Konsistenz, Vollständigkeit, Korrektheit und Nutzbarkeit. |
| Open World Assumption | Die Open World Assumption ist das Prinzip, dass eine nicht in der Wissensbasis enthaltene Aussage nicht als falsch gilt, sondern als unbekannt betrachtet wird. Sie ist fundamental für OWL-Ontologien und das Semantic Web. |
| Parametrisches Wissen | Parametrisches Wissen ist das in den Gewichten eines neuronalen Netzes gespeicherte Wissen, das während des Trainings aus dem Trainingskorpus extrahiert und implizit kodiert wurde. Es bildet das Kernwissen eines Large Language Models. |
| Pillar-Cluster-Modell | Das Pillar-Cluster-Modell ist eine Content-Architektur, bei der eine umfassende Pillar Page als thematisches Zentrum fungiert und durch verlinkte Cluster-Inhalte ergänzt wird. Es verbindet Nutzerfreundlichkeit mit systematischer Suchmaschinenoptimierung. |
| Polysemie | Polysemie bezeichnet das Phänomen, dass ein einzelnes Wort oder ein Ausdruck mehrere unterschiedliche, aber verwandte Bedeutungen tragen kann. Sie ist eine der grundlegenden Herausforderungen natürlicher Sprache und jeder semantischen Infrastruktur. |
| Precision (semantisch) | Semantische Precision misst den Anteil der korrekt als relevant eingestuften Ergebnisse an allen zurückgegebenen Ergebnissen. In der semantischen Suche und der Entity Recognition gibt Precision Auskunft darüber, wie präzise ein System arbeitet. |
| Query Fan-Out | Query Fan-Out ist die Technik, bei der ein KI-System eine komplexe Nutzeranfrage in mehrere Teilanfragen zerlegt und parallel verschiedene Informationsquellen abfragt. Dieser Mechanismus verbessert die Qualität und Vollständigkeit der Antworten erheblich. |
| Query Understanding | Query Understanding ist der Prozess, durch den Suchmaschinen die Bedeutung, Intention und den Kontext einer Suchanfrage analysieren und interpretieren. Es umfasst multiple Verarbeitungsschritte von der Tokenisierung bis zur semantischen Interpretation. |
| RAG-Retrievability | RAG-Retrievability ist die Eigenschaft von Inhalten, durch Retrieval-Augmented-Generation-Systeme effektiv gefunden, extrahiert und in generierte Antworten eingebunden zu werden. Sie ist ein zunehmend wichtiger Qualitätsindikator für digitale Inhalte. |
| Recall (semantisch) | Semantischer Recall misst den Anteil der tatsächlich relevanten Ergebnisse, die von einem System gefunden wurden, an der Gesamtmenge aller relevanten Ergebnisse. Diese Metrik beantwortet die zentrale Frage der Vollständigkeit: Findet das System alle relevanten Dokumente, oder werden einige übersehen? |
| Relevanz-Scoring | Relevanz-Scoring ist die automatische Bewertung und Rangfolgebildung von Dokumenten, Entitäten oder Inhalten nach ihrer Relevanz für eine bestimmte Anfrage oder ein bestimmtes Kriterium. Dieser Mechanismus bestimmt, welche Ergebnisse in welcher Reihenfolge präsentiert werden. |
| Search Entity Recognition | Search Entity Recognition ist die Fähigkeit von Suchmaschinen, Entitäten in Suchanfragen und Dokumenten automatisch zu identifizieren und dem Knowledge Graph zuzuordnen. Diese Erkennung bildet die Grundlage der semantischen Suche und bestimmt, wie Inhalte in das Netz der Wissensdatenbank eingebunden werden. |
| Semantische Ähnlichkeit | Semantische Ähnlichkeit quantifiziert den Grad der Bedeutungsübereinstimmung zwischen zwei sprachlichen Ausdrücken, Konzepten oder Dokumenten. Im Gegensatz zur lexikalischen Ähnlichkeit erfasst sie die Bedeutungsebene. |
| Semantische Annotation | Semantische Annotation ist die Anreicherung von Webinhalten mit maschinenlesbaren Bedeutungsmarkierungen, die Entitäten, Typen und Relationen explizit kennzeichnen. |
| Semantische Dichte | Semantische Dichte beschreibt das Verhältnis von bedeutungstragenden Informationseinheiten zur Gesamtlänge eines Textes. Sie misst, wie viele relevante, verwertbare Aussagen pro Texteinheit enthalten sind, und ist ein zentrales Qualitätsmerkmal für Inhalte innerhalb einer semantischen Infrastruktur. |
| Semantische Differenzierung | Semantische Differenzierung ist die strategische Abgrenzung einer Marke, eines Angebots oder einer Entität durch die Besetzung einzigartiger Bedeutungsräume im Bewusstsein von Menschen und Algorithmen. |
| Semantische Distanz | Semantische Distanz misst den Grad der Bedeutungsunterschiedlichkeit zwischen zwei Konzepten, Entitäten oder Ausdrücken in einem Bedeutungsraum. Je größer die Distanz, desto unterschiedlicher sind die Bedeutungen. |
| Semantische Governance | Semantische Governance umfasst die Prozesse, Rollen, Regeln und Verantwortlichkeiten, die sicherstellen, dass die semantische Infrastruktur konsistent, qualitativ hochwertig und zweckdienlich bleibt. Sie ist das organisatorische Rahmenwerk für den langfristigen Betrieb. |
| Semantische Interoperabilität | Semantische Interoperabilität ist die Fähigkeit verschiedener Systeme, Daten und Informationen nicht nur technisch auszutauschen, sondern deren Bedeutung korrekt zu interpretieren. |
| Semantische Kohärenz | Semantische Kohärenz bezeichnet den logischen und thematischen Zusammenhalt zwischen den Aussagen eines Textes, einer Ontologie oder eines Content-Clusters. Alle Teile eines Inhalts müssen sinnvoll miteinander verbunden sein und ein konsistentes Gesamtbild ergeben. |
| Semantische Kongruenz | Semantische Kongruenz beschreibt die Übereinstimmung zwischen der kommunizierten Bedeutung und der tatsächlichen Identität, Leistung oder Realität eines Unternehmens. Sie verbindet Markenführung, Kommunikation und semantische Infrastruktur. |
| Semantische Kongruenz (intern/extern) | Semantische Kongruenz (intern/extern) adressiert die Übereinstimmung der Bedeutungen innerhalb eines Unternehmens sowie zwischen Unternehmen und Außenwelt. Interne Kongruenz sichert einheitliches Begriffsverständnis, externe Kongruenz sichert die Übereinstimmung von Selbstdarstellung und Realität. |
| Semantische Konsistenz | Semantische Konsistenz bedeutet, dass Begriffe, Definitionen und Aussagen innerhalb eines Systems widerspruchsfrei und einheitlich verwendet werden. Ein konsistentes System erlaubt es, dass Schlussfolgerungen aus den definierten Relationen immer gültig sind. |
| Semantische Lückenanalyse | Die semantische Lückenanalyse gleicht den vorhandenen Inhaltsbestand eines Publishers systematisch gegen den vollständigen Bedeutungsraum eines Themas ab. Sie nutzt Ontologien und semantische Modelle als Referenz und geht damit weit über klassische Keyword-Gap-Analysen hinaus. |
| Semantische Reife | Semantische Reife beschreibt den Entwicklungsstand einer Organisation hinsichtlich ihrer Fähigkeit, semantische Technologien und Prinzipien systematisch für ihre Ziele einzusetzen. Das Reifegradmodell hilft bei der Einschätzung des aktuellen Stands und der Planung nächster Schritte. |
| Semantische Relationen | Semantische Relationen sind die bedeutungstragenden Verbindungen zwischen Konzepten, Entitäten oder Wörtern, die deren Beziehungen zueinander formal beschreiben. Sie bilden das Verbindungsgewebe jeder Wissensstruktur. |
| Semantische Skalierung | Semantische Skalierung beschreibt die Fähigkeit einer semantischen Infrastruktur, bei wachsendem Inhaltsvolumen, zunehmender Domänenkomplexität und steigender Nutzerzahl die semantische Qualität aufrechtzuerhalten. Sie adressiert die Frage, ob die Bedeutungsqualität bei wachsender Größe erhalten bleibt. |
| Semantische Suche | Semantische Suche ist ein Suchparadigma, das die Bedeutung von Anfragen und Inhalten analysiert, um relevante Ergebnisse basierend auf Entitäten, Kontext und Intention zu liefern. |
| Semantische Suchintention | Semantische Suchintention beschreibt die tatsächliche Absicht und den Informationsbedarf hinter einer Suchanfrage, die über den wörtlichen Text der Anfrage hinausgeht. Sie ist ein Schlüsselaspekt moderner Suchmaschinenoptimierung. |
| Semantische Vernetzung | Semantische Vernetzung ist die gezielte Schaffung von Bedeutungsverbindungen zwischen Inhalten, Entitäten und Konzepten über verschiedene Ebenen und Kanäle hinweg. Sie geht über einfache Hyperlinks hinaus und beschreibt ein Netzwerk aus Bedeutungsbeziehungen, das für Menschen und Algorithmen navigierbar ist. |
| Semantisches Feld | Ein semantisches Feld ist eine Gruppe von Wörtern und Ausdrücken, die durch gemeinsame Bedeutungskomponenten miteinander verbunden sind und einen Themenbereich abdecken. |
| Semantisches Framing | Semantisches Framing ist die bewusste Wahl von Begriffen, Metaphern und Konzeptrahmen, die die Interpretation und Wahrnehmung einer Botschaft steuern. Die Framing-Theorie zeigt, dass die Wortwahl den Interpretationsrahmen für alle weiteren Informationen setzt. |
| Semantisches Mapping | Semantisches Mapping ist der Prozess, Konzepte, Begriffe oder Datenstrukturen eines Systems auf die entsprechenden Elemente eines anderen Systems abzubilden und deren Bedeutungsbeziehungen zu definieren. Es wird immer dann benötigt, wenn verschiedene Wissensrepräsentationen miteinander verbunden werden müssen. |
| Semantisches Monitoring | Semantisches Monitoring ist die kontinuierliche Überwachung und Analyse der semantischen Darstellung einer Entität, Marke oder Domäne in Suchmaschinen, KI-Systemen und anderen algorithmischen Plattformen. Es erweitert klassisches SEO-Monitoring um die Dimension der Bedeutungsrepräsentation. |
| SERP-Analyse | SERP-Analyse ist die systematische Untersuchung der Suchergebnisseite, um die von Suchmaschinen erkannte Suchintention, den Wettbewerb und die optimale Content-Strategie abzuleiten. Sie interpretiert die Zusammensetzung der Ergebnisseite als Ausdruck des algorithmischen Verständnisses einer Suchanfrage. |
| Share of Voice | Share of Voice misst den Anteil der Sichtbarkeit einer Marke im Vergleich zum Gesamtmarkt über alle relevanten Kanäle hinweg. Die Metrik umfasst organische Suchsichtbarkeit, Präsenz in KI-generierten Antworten, Social-Media-Reichweite und Repräsentationen in Knowledge Graphs. |
| Terminologiemanagement | Terminologiemanagement ist die systematische Erfassung, Definition, Verwaltung und Kontrolle der Fachbegriffe und Benennungen eines Unternehmens oder einer Domäne. Als operatives Fundament der semantischen Infrastruktur klärt es die Begriffe, bevor eine Ontologie erstellt werden kann. |
| TF-IDF | TF-IDF (Term Frequency-Inverse Document Frequency) ist eine statistische Methode zur Bewertung der Wichtigkeit eines Begriffs für ein Dokument relativ zu einem Dokumentenkorpus. Sie identifiziert Begriffe, die für ein bestimmtes Dokument besonders charakteristisch sind. |
| Thematische Relevanz | Thematische Relevanz beschreibt den Grad der inhaltlichen Übereinstimmung zwischen einem Dokument und einer Suchanfrage oder einem übergeordneten Thema. Sie ist das fundamentale Kriterium, nach dem Suchmaschinen Dokumente bewerten und ranken. |
| Token Co-Occurrence | Token Co-Occurrence beschreibt die statistischen Muster des gemeinsamen Auftretens von Tokens in den Trainingsdaten von Sprachmodellen, die deren gelerntes Wissen formen. Dieses Prinzip erklärt, wie LLMs Wissen erwerben und Assoziationen bilden. |
| Topical Authority | Topical Authority ist das Mass, in dem eine Website oder ein Publisher von Suchmaschinen als umfassend kompetent und vertrauenswürdig für ein bestimmtes Themengebiet anerkannt wird. |
| Vererbung | Vererbung ist das Prinzip, dass untergeordnete Klassen in einer Ontologie automatisch alle Eigenschaften und Relationen ihrer übergeordneten Klassen übernehmen. Dies reduziert Redundanz und stellt Konsistenz sicher. |
| Vollständigkeit | Vollständigkeit ist das Qualitätskriterium, das bewertet, ob eine Wissensrepräsentation, Ontologie oder Inhaltssammlung alle relevanten Aspekte einer Domäne angemessen erfasst. Als relatives Konzept wird sie immer im Verhältnis zum definierten Zweck und Geltungsbereich bewertet. |
| Wissensextraktion | Wissensextraktion ist der automatisierte oder semi-automatisierte Prozess, strukturierte Informationen wie Entitäten, Relationen und Fakten aus unstrukturierten Datenquellen wie Texten zu gewinnen. |
| Wissensmodellierung | Wissensmodellierung ist der systematische Prozess, das Wissen einer Domäne in formale oder semi-formale Strukturen zu überführen, die von Menschen und Maschinen verarbeitet werden können. Sie umfasst Erhebung, Analyse, Strukturierung und iterative Verfeinerung von Domänenwissen. |
| Wissensrepräsentation | Wissensrepräsentation ist die systematische Methode, Wissen so zu strukturieren und zu kodieren, dass es von Menschen und Maschinen gespeichert, abgerufen und verarbeitet werden kann. |
| Wissensschnitt | Der Wissensschnitt (Knowledge Cutoff) eines LLMs ist der zeitliche Grenzpunkt, bis zu dem Trainingsdaten berücksichtigt wurden und ab dem das parametrische Wissen des Modells keine Informationen mehr enthält. |
| Zitierfähigkeit | Zitierfähigkeit beschreibt die Eigenschaft von Inhalten, durch KI-Systeme als verlässliche, attribuierbare Quelle in generierten Antworten verwendet zu werden. Sie ist ein neues Qualitätsmerkmal, das durch die Verbreitung von KI-Systemen mit Quellenangaben an Bedeutung gewinnt. |
Entitäten (112)
| Name ▲ | Kurzbeschreibung |
|---|---|
| @id | @id ist das JSON-LD-Schlüsselwort, das einer Entität einen eindeutigen Identifikator in Form eines URI zuweist. |
| AEO | AEO (Answer Engine Optimization) ist die Optimierung von Inhalten für KI-gestützte Antwortsysteme, die direkte Antworten statt Linklisten liefern. |
| Attribut | Ein Attribut ist eine Eigenschaft oder ein Merkmal einer Entität, das einen konkreten Datenwert wie einen Namen, ein Datum oder eine Zahl trägt. |
| Bedeutungsraum | Ein Bedeutungsraum ist das semantische Feld, in dem verwandte Entitäten, Konzepte und ihre Beziehungen zueinander existieren und interpretiert werden. |
| Brand Entity | Eine Brand Entity ist die maschinenlesbare Repräsentation einer Marke im Knowledge Graph mit eindeutigen Identifikatoren, Attributen und Relationen. |
| Brand Mention | Eine Brand Mention ist die Erwähnung einer Marke in einem Webinhalt, die auch ohne Hyperlink als Signal für die Relevanz und Bekanntheit der Entität gewertet wird. |
| Citation | Eine Citation ist die Quellenangabe in einer KI-generierten Antwort, die den Ursprung einer Information nachvollziehbar einer bestimmten Webseite zuordnet. |
| Co-Occurrence | Co-Occurrence bezeichnet das gemeinsame Auftreten von Begriffen oder Entitäten in einem Text, das auf semantische Zusammenhänge und Beziehungen hinweist. |
| Content | Content bezeichnet sämtliche digitalen Inhalte, Texte, Bilder, Videos, Daten, die auf Webseiten veröffentlicht werden und als Rohstoff der semantischen Infrastruktur dienen. |
| Content Hub | Ein Content Hub ist der übergeordnete strategische Knotenpunkt, der alle Topic Cluster zu einem Oberthema bündelt und die höchste Ebene der Content-Hierarchie bildet. |
| Content-Ersteller | Content-Ersteller sind die Produzenten der Inhalte, die den Rohstoff der semantischen Infrastruktur bilden. Ihre Aufgabe umfasst nicht nur das Verfassen von Texten, sondern auch die semantisch korrekte Strukturierung und die Optimierung für KI-Systeme. |
| Contextual Relevance | Contextual Relevance beschreibt die Bedeutung eines Inhalts im spezifischen Kontext der Suchanfrage, der Nutzersituation und der umgebenden Informationen. |
| Corporate Identity | Corporate Identity ist das konsistente Gesamterscheinungsbild eines Unternehmens, das in der semantischen Infrastruktur durch einheitliche Entitätsdaten über alle Kanäle realisiert wird. |
| Corroboration | Corroboration ist die Bestätigung von Fakten über eine Entität durch übereinstimmende Informationen aus mehreren unabhängigen Quellen. Sie ist das Vertrauensprinzip, nach dem Knowledge Graphs entscheiden, welche Fakten aufgenommen werden. |
| Crawler | Ein Crawler ist ein automatisierter Software-Agent, der systematisch Webseiten abruft, Links verfolgt und Inhalte samt strukturierten Daten zur Verarbeitung durch die Suchmaschine sammelt. |
| Crawling | Crawling ist der automatisierte Prozess, bei dem Suchmaschinen-Bots systematisch Webseiten abrufen, um deren Inhalte zu erfassen und zur Indexierung vorzubereiten. |
| DBpedia | DBpedia ist ein offener Knowledge Graph, der strukturierte Informationen aus Wikipedia-Artikeln extrahiert und als Linked Data im RDF-Format bereitstellt. |
| Disambiguierung | Disambiguierung ist der Prozess der Auflösung von Mehrdeutigkeiten, bei dem einem Ausdruck im jeweiligen Kontext die korrekte Bedeutung zugeordnet wird. |
| Dokument | Ein Dokument ist eine abgeschlossene Informationseinheit im Web, die durch eine URL identifiziert wird und eine oder mehrere Entitäten behandelt. |
| E-E-A-T | E-E-A-T steht für Experience, Expertise, Authoritativeness und Trustworthiness. Diese Kriterien aus den Google Search Quality Rater Guidelines beschreiben, woran menschliche Bewerter die Qualität von Suchergebnissen messen. Das 2022 ergänzte E für Experience betont die Bedeutung von Erfahrung aus erster Hand. |
| Embedding | Ein Embedding ist eine dichte Vektorrepräsentation eines Worts, Satzes oder Dokuments in einem mehrdimensionalen Raum, in dem semantische Ähnlichkeit durch räumliche Nähe ausgedrückt wird. |
| Entität | Eine Entität ist ein eindeutig identifizierbares Objekt oder Konzept mit definierten Attributen und Beziehungen innerhalb eines Wissensraums. |
| Entitätsbeziehung | Eine Entitätsbeziehung ist eine spezifische, typisierte Verbindung zwischen zwei Entitäten, die deren semantischen Zusammenhang im Knowledge Graph beschreibt. |
| Entity Disambiguation | Entity Disambiguation ist die gezielte Unterscheidung gleichnamiger Entitäten durch Kontextanalyse und Verknüpfung mit eindeutigen Identifikatoren in Wissensbasen. |
| Entity Home | Eine Entity Home ist die zentrale Webseite einer Entität, die alle wesentlichen Fakten, Attribute und Verknüpfungen dieser Entität an einem Ort versammelt. |
| Entity Linking | Entity Linking folgt auf die Named Entity Recognition und löst die Aufgabe der Disambiguierung: Es entscheidet, welche konkrete Entität in einem Wissenssystem bei einer mehrdeutigen Erwähnung gemeint ist. |
| Entity Salience | Entity Salience misst die Wichtigkeit und Zentralität einer Entität innerhalb eines Textes im Verhältnis zu allen anderen im Text vorkommenden Entitäten. |
| Entity SEO | Entity SEO ist die Strategie, eine Marke, Person oder ein Produkt als erkannte Entität im Knowledge Graph zu etablieren und semantisch zu optimieren. |
| Featured Snippet | Featured Snippets werden von Google algorithmisch aus Webseiten extrahiert und in einem hervorgehobenen Kasten oberhalb der organischen Ergebnisse angezeigt. Sie existieren als Absatz-, Listen-, Tabellen- und Video-Snippets und sind häufig die Quelle für Voice-Search-Antworten und AI Overviews. |
| Freebase | Freebase war eine offene, kollaborative Wissensdatenbank von Google, deren Daten in den Google Knowledge Graph überführt und teilweise an Wikidata übertragen wurden. |
| Google ist die dominierende Suchmaschine und der zentrale Akteur im Ökosystem der semantischen Infrastruktur, der mit seinem Knowledge Graph die Entitätsbasierung der Suche vorangetrieben hat. | |
| Grounding | Grounding ist die Verankerung von KI-Antworten in verifizierbaren Quellen, um Halluzinationen zu vermeiden und Faktentreue sicherzustellen. Es verbindet strukturierte Daten und KI-Generierung in der semantischen Infrastruktur. |
| Halluzination | Halluzinationen entstehen, weil Large Language Models Sprache statistisch modellieren und nicht über ein verifiziertes Faktengedächtnis verfügen. Sie können Fakten, Daten oder Zusammenhänge erfinden, die konsistent klingen, aber nicht der Realität entsprechen. |
| Indexierung | Indexierung ist der Prozess, bei dem Suchmaschinen gecrawlte Webseiten analysieren, ihre Inhalte und strukturierten Daten verarbeiten und im Suchindex speichern. |
| Inferenz | Inferenz ist der logische Schlussfolgerungsprozess, bei dem aus explizit vorhandenen Fakten und Regeln neues, implizites Wissen abgeleitet wird. |
| Informationsarchitektur | Informationsarchitektur ist die Disziplin der Strukturierung, Organisation und Benennung von Informationen, um Findbarkeit und Verständlichkeit für Nutzer zu optimieren. |
| Instanz | Eine Instanz ist ein konkretes Einzelobjekt, das einer Klasse in einer Ontologie zugeordnet ist und deren definierte Eigenschaften mit spezifischen Werten ausfüllt. |
| Interne Verlinkung | Interne Verlinkung ist die systematische Verknüpfung von Seiten innerhalb einer Website, die die thematische Struktur für Nutzer und Suchmaschinen kommuniziert. |
| JSON-LD | JSON-LD (JavaScript Object Notation for Linked Data) ist ein leichtgewichtiges Datenformat zur Einbettung strukturierter Daten in Webseiten, das von Suchmaschinen bevorzugt wird. |
| Kanonische URL | Eine kanonische URL ist die von Suchmaschinen bevorzugte Standardadresse einer Webseite, die bei mehreren erreichbaren Versionen als die maßgebliche deklariert wird. |
| Keyword | Ein Keyword ist ein Suchbegriff oder eine Suchphrase, die Nutzer in Suchmaschinen eingeben und die als Ausgangspunkt für die Inhaltsoptimierung dient. |
| Klasse | Eine Klasse ist eine abstrakte Kategorie in einer Ontologie, die eine Menge von Entitäten mit gemeinsamen Eigenschaften zusammenfasst. |
| Knowledge Graph | Ein Knowledge Graph ist eine vernetzte Wissensdatenbank, die Entitäten und ihre Beziehungen als Graph aus Knoten und Kanten maschinenlesbar strukturiert. |
| Knowledge Graph Completion | Knowledge Graph Completion nutzt verschiedene Techniken, um Lücken in Wissensgraphen zu schliessen. Dazu gehören logische Inferenz basierend auf OWL-Regeln, statistische Mustererkennung in bestehenden Graphstrukturen und neuronale Methoden wie Knowledge Graph Embeddings. |
| Knowledge Panel | Knowledge Panels erscheinen rechts neben den organischen Suchergebnissen und zeigen kompakte Informationen über Personen, Organisationen, Orte oder Konzepte. Die Daten stammen aus dem Google Knowledge Graph und werden aus Quellen wie Wikidata, Wikipedia und Schema.org-Markup aggregiert. |
| Knowledge Panel Claim | Ein Knowledge Panel Claim ist die verifizierte Beanspruchung eines Knowledge Panels durch die dargestellte Entität über die Google Search Console. |
| Knowledge Vault | Knowledge Vault ist ein von Google entwickeltes System zur automatischen Extraktion und Fusion von Fakten aus dem Web in einen probabilistischen Knowledge Graph. |
| Kontrolliertes Vokabular | Ein kontrolliertes Vokabular ist eine festgelegte Menge von Begriffen mit eindeutigen Definitionen, die die einheitliche Benennung von Konzepten in einem Wissensgebiet sicherstellt. |
| Konzept | Ein Konzept ist eine abstrakte Bedeutungseinheit, die eine Idee, eine Kategorie oder einen Sachverhalt unabhängig von einer konkreten sprachlichen Bezeichnung repräsentiert. |
| Large Language Model | Ein Large Language Model (LLM) ist ein neuronales Netzwerk mit Milliarden von Parametern, das auf riesigen Textmengen trainiert wurde, um natürliche Sprache zu verstehen und zu generieren. |
| Linked Data | Linked Data folgt vier Prinzipien, die Tim Berners-Lee 2006 formulierte: Verwende URIs zur Identifikation, mache URIs dereferenzierbar via HTTP, liefere Informationen in RDF, und verlinke auf andere URIs. So entsteht ein globales Netz verknüpfter Daten, in dem Maschinen von Datensatz zu Datensatz navigieren können. |
| Marke | Eine Marke ist eine Entität mit eigener Identität, die durch konsistente Attribute, Assoziationen und Wiedererkennungsmerkmale im Bewusstsein der Zielgruppe verankert ist. |
| Markup | Markup bezeichnet die strukturelle und semantische Auszeichnung von Webinhalten durch HTML-Tags und ergänzende Formate wie JSON-LD oder Microdata. |
| Microdata | Microdata ist ein HTML-basiertes Format zur Einbettung strukturierter Daten direkt in den sichtbaren Quellcode einer Webseite mittels spezieller Attribute. |
| Multimodale Semantik | Multimodale Semantik erweitert das semantische Verständnis über die Textebene hinaus und integriert Bilder, Videos, Audioinhalte und deren Wechselwirkungen. In der semantischen Infrastruktur bedeutet dies, dass nicht nur Texte, sondern alle Inhaltsformate semantisch ausgezeichnet und strukturiert werden müssen. |
| Named Entity | Named Entities unterscheiden sich von generischen Konzepten durch ihre Einzigartigkeit und Benennbarkeit. In der semantischen Infrastruktur bilden Named Entities die konkreten Datenobjekte, über die Wissen gespeichert wird. Knowledge Graphs bestehen überwiegend aus Named Entities und ihren Beziehungen. |
| Named Entity Recognition | Named Entity Recognition (NER) ist ein NLP-Verfahren zur automatischen Erkennung und Klassifikation von benannten Entitäten wie Personen, Orten und Organisationen in Texten. |
| Named Graph | Ein Named Graph ist eine benannte Teilmenge von RDF-Triples innerhalb einer Wissensdatenbank, die als eigenständige Einheit referenziert und verwaltet werden kann. |
| Natural Language Processing | Natural Language Processing umfasst Technologien wie Tokenisierung, Part-of-Speech-Tagging, Named Entity Recognition, Sentiment-Analyse, Textklassifikation und maschinelle Übersetzung. NLP ist die Basistechnologie, die Suchmaschinen und KI-Systeme befähigt, die Bedeutung von Texten zu verstehen. |
| Notabilität | Notabilität bezeichnet die Bedeutsamkeit einer Entität, die über einen Schwellenwert hinaus nachweisbar sein muss, um als eigenständiger Eintrag in Wissensbasen wie Wikipedia oder dem Knowledge Graph zu gelten. |
| Ontologie | Eine Ontologie ist ein formales Modell, das die Entitäten einer Wissensdomäne, ihre Eigenschaften und die Relationen zwischen ihnen explizit und maschinenlesbar beschreibt. |
| OWL | OWL (Web Ontology Language) ist die vom W3C standardisierte Sprache zur Definition formaler Ontologien mit logikbasierter Ausdruckskraft im Semantic Web. |
| People Also Ask | People Also Ask ist ein Google-SERP-Feature, das verwandte Fragen zu einer Suchanfrage in einem erweiterbaren Akkordeon-Format anzeigt. |
| Personal Brand | Eine Personal Brand ist die strategische Positionierung einer Person als erkannte Entität mit definiertem Expertenstatus in einer oder mehreren Wissensdomänen. |
| Pillar Page | Eine Pillar Page ist eine umfassende Hauptseite zu einem übergeordneten Thema, die als zentraler Anker eines Topic Clusters fungiert und auf alle zugehörigen Unterseiten verlinkt. |
| Prompt | Ein Prompt ist die Eingabeanweisung an ein Sprachmodell, die dessen Verhalten, Kontext und die erwartete Ausgabe steuert. |
| Property | Eine Property ist ein benanntes Feld in einem Schema, das entweder ein Attribut mit Datenwert oder eine Relation zu einer anderen Entität ausdrückt. |
| Property Graph | Ein Property Graph ist ein Graphmodell, in dem sowohl Knoten als auch Kanten beliebige Schlüssel-Wert-Paare als Eigenschaften tragen können. |
| RAG | RAG (Retrieval Augmented Generation) ist eine KI-Architektur, die ein Large Language Model mit einer externen Wissensbasis verbindet, um faktisch fundierte Antworten zu generieren. |
| RDF | RDF (Resource Description Framework) ist das standardisierte Datenmodell des W3C zur Beschreibung von Ressourcen und ihren Beziehungen im Semantic Web. |
| RDFa | RDFa (Resource Description Framework in Attributes) ist ein W3C-Standard zur Einbettung von RDF-Triples in HTML-Attribute, der strukturierte Daten direkt im Seitenmarkup codiert. |
| Reasoner | Ein Reasoner ist eine Software, die auf Basis formaler Ontologien logische Schlussfolgerungen zieht, Konsistenz prüft und implizites Wissen aus expliziten Fakten ableitet. |
| Relation | Eine Relation ist eine gerichtete, typisierte Beziehung zwischen zwei Entitäten, die deren semantischen Zusammenhang beschreibt. |
| Retrieval | Retrieval ist der Prozess des gezielten Auffindens und Abrufens relevanter Informationen aus einer Wissensbasis als Antwort auf eine Anfrage. |
| Rich Results | Rich Results sind erweiterte Suchergebnisse mit visuellen und strukturierten Zusatzinformationen, die auf der Auswertung von Structured Data basieren. |
| sameAs | sameAs ist eine Schema.org-Property, die eine Entität mit ihren Profilen und Einträgen auf externen Plattformen verknüpft und so deren eindeutige Identifikation ermöglicht. |
| Schema | Ein Schema ist eine strukturelle Beschreibung, die den Aufbau, die erlaubten Datentypen und die Beziehungen innerhalb eines Datensatzes oder einer Wissensdomäne festlegt. |
| Schema.org | Schema.org ist ein gemeinsames Vokabular von Google, Microsoft, Yahoo und Yandex, das standardisierte Typen und Properties für strukturierte Daten im Web definiert. |
| Semantic Layer | Der Semantic Layer ist die Bedeutungsschicht über den Rohdaten, die durch Ontologien, Vokabulare und Markup Maschinen das Verständnis der Daten ermöglicht. |
| Semantic Search | Semantic Search ist eine Suchtechnologie, die die Bedeutung und den Kontext von Suchanfragen und Inhalten versteht, statt sich auf reine Keyword-Übereinstimmungen zu beschränken. |
| Semantic Web | Das Semantic Web ist die von Tim Berners-Lee vorgeschlagene Erweiterung des World Wide Web, in der Informationen mit maschinenlesbarer Bedeutung versehen werden. |
| Semantik | Semantik ist die Lehre von der Bedeutung sprachlicher Zeichen, Sätze und Texte sowie deren Interpretation durch Menschen und Maschinen. |
| Semantische Annotation | Semantische Annotation ist die Anreicherung von Webinhalten mit maschinenlesbaren Bedeutungsmarkierungen, die Entitäten, Typen und Relationen explizit kennzeichnen. |
| Semantische Interoperabilität | Semantische Interoperabilität ist die Fähigkeit verschiedener Systeme, Daten und Informationen nicht nur technisch auszutauschen, sondern deren Bedeutung korrekt zu interpretieren. |
| Semantische Lücke | Eine semantische Lücke ist ein fehlendes Konzept, eine unbehandelte Entität oder eine nicht abgedeckte Beziehung innerhalb der inhaltlichen Abbildung eines Themenfelds. |
| Semantische Suche | Semantische Suche ist ein Suchparadigma, das die Bedeutung von Anfragen und Inhalten analysiert, um relevante Ergebnisse basierend auf Entitäten, Kontext und Intention zu liefern. |
| Semantische Triplifikation | Semantische Triplifikation ist die Überführung unstrukturierter oder semistrukturierter Daten in das RDF-Triple-Format zur Integration in Knowledge Graphs. |
| Semantisches Feld | Ein semantisches Feld ist eine Gruppe von Wörtern und Ausdrücken, die durch gemeinsame Bedeutungskomponenten miteinander verbunden sind und einen Themenbereich abdecken. |
| SEO-Spezialist | Ein SEO-Spezialist ist ein Fachexperte für die Optimierung von Webinhalten für Suchmaschinen, der zunehmend semantische Strategien und Entitätsmodellierung einsetzt. |
| SERP | Eine SERP (Search Engine Results Page) ist die Ergebnisseite einer Suchmaschine, die organische Treffer, Rich Results, Knowledge Panels und weitere Elemente anzeigt. |
| Snippet | Ein Snippet ist die Textvorschau eines Suchergebnisses in der SERP, bestehend aus Titel, URL und Beschreibung, die den Nutzer zum Klick bewegen soll. |
| SPARQL | SPARQL ist die standardisierte Abfragesprache für RDF-Daten, die es ermöglicht, Knowledge Graphs gezielt nach Mustern von Triples zu durchsuchen. |
| Speakable Schema | Speakable Schema ist ein Schema.org-Markup, das Textabschnitte einer Webseite als besonders geeignet für die Sprachausgabe durch Voice-Search-Systeme und Smart Speaker kennzeichnet. |
| Structured Data | Structured Data sind maschinenlesbar codierte Informationen auf Webseiten, die Suchmaschinen das Verständnis von Inhalt, Entitäten und deren Beziehungen ermöglichen. |
| Suchintention | Die Suchintention ist die zugrunde liegende Absicht eines Nutzers bei einer Suchanfrage, die bestimmt, welche Art von Ergebnis erwartet wird. |
| Suchmaschine | Eine Suchmaschine ist ein System, das Webinhalte crawlt, indexiert und auf Suchanfragen hin relevante Ergebnisse liefert, zunehmend basierend auf semantischem Verständnis. |
| Taxonomie | Eine Taxonomie ist ein hierarchisches Klassifikationssystem, das Konzepte in Über- und Unterordnungsbeziehungen strukturiert. |
| Thesaurus | Ein Thesaurus ist ein kontrolliertes Vokabular, das Begriffe durch Synonymie-, Hierarchie- und Assoziationsbeziehungen miteinander verknüpft. |
| Token | Ein Token ist die kleinste Verarbeitungseinheit eines Sprachmodells, also ein Wort, ein Wortteil oder ein Satzzeichen, in die Text für die maschinelle Verarbeitung zerlegt wird. |
| Topic Cluster | Ein Topic Cluster ist eine Content-Struktur, die eine Pillar Page als thematisches Zentrum mit mehreren Cluster-Seiten zu Unterthemen durch systematische Verlinkung verbindet. |
| Topical Authority | Topical Authority ist das Mass, in dem eine Website oder ein Publisher von Suchmaschinen als umfassend kompetent und vertrauenswürdig für ein bestimmtes Themengebiet anerkannt wird. |
| Triple | Ein Triple ist die elementare Aussageeinheit im Semantic Web, bestehend aus Subjekt, Prädikat und Objekt, die eine einzelne Faktenbeziehung beschreibt. |
| URI | URIs sind das Identitätsfundament des semantischen Webs — ohne persistente, konsistente Kennungen zerfällt jede Wissensstruktur. |
| User | Der User ist der Mensch, der eine Suchanfrage stellt oder mit einem KI-System interagiert und dessen Informationsbedürfnis die gesamte semantische Infrastruktur bedienen soll. |
| Vektor | Ein Vektor ist eine geordnete Liste von Zahlen, die in der semantischen Infrastruktur als mathematische Repräsentation von Bedeutung in einem mehrdimensionalen Raum dient. |
| Vektordatenbank | Vektordatenbanken wie Qdrant, Pinecone, Weaviate und Milvus sind optimiert für die Speicherung von Embeddings und die schnelle Suche nach den ähnlichsten Vektoren zu einer Anfrage. Sie bilden die technische Grundlage für semantische Suche und RAG-Systeme. |
| Vokabular | Ein Vokabular ist eine definierte Menge von Begriffen, Klassen und Properties, die zur einheitlichen Beschreibung von Entitäten in einem bestimmten Kontext verwendet werden. |
| Webseite | Eine Webseite ist ein zusammenhängendes digitales Informationsangebot unter einer Domain, das als Gesamtheit die semantische Infrastruktur einer Marke oder Organisation abbildet. |
| Wikidata | Wikidata ist eine freie, kollaborative Wissensdatenbank der Wikimedia Foundation, die strukturierte Daten mit eindeutigen Identifikatoren für Millionen von Entitäten bereitstellt. |
| Wissensdomäne | Eine Wissensdomäne ist ein abgegrenzter Fachbereich mit eigenem Vokabular, eigenen Konzepten und spezifischen Regeln der Wissensorganisation. |
| Wissensextraktion | Wissensextraktion ist der automatisierte oder semi-automatisierte Prozess, strukturierte Informationen wie Entitäten, Relationen und Fakten aus unstrukturierten Datenquellen wie Texten zu gewinnen. |
| Wissensrepräsentation | Wissensrepräsentation ist die systematische Methode, Wissen so zu strukturieren und zu kodieren, dass es von Menschen und Maschinen gespeichert, abgerufen und verarbeitet werden kann. |